新模型层出不穷,为什么企业升级起来却那么难?
新模型层出不穷,为什么企业升级起来却那么难?
这是「AI自动化指南」AI Gateway 系列的第五篇。
一个总在发生的场景
某天,技术负责人想统一处理一件事——可能是某个供应商的模型要下线了,可能是安全合规要求禁用某个模型,也可能只是想把预算集中到性价比更高的那几个模型上。他要做的第一件事,是搞清楚"我们现在到底有哪些系统在用模型、用的是谁家的、哪个版本"。
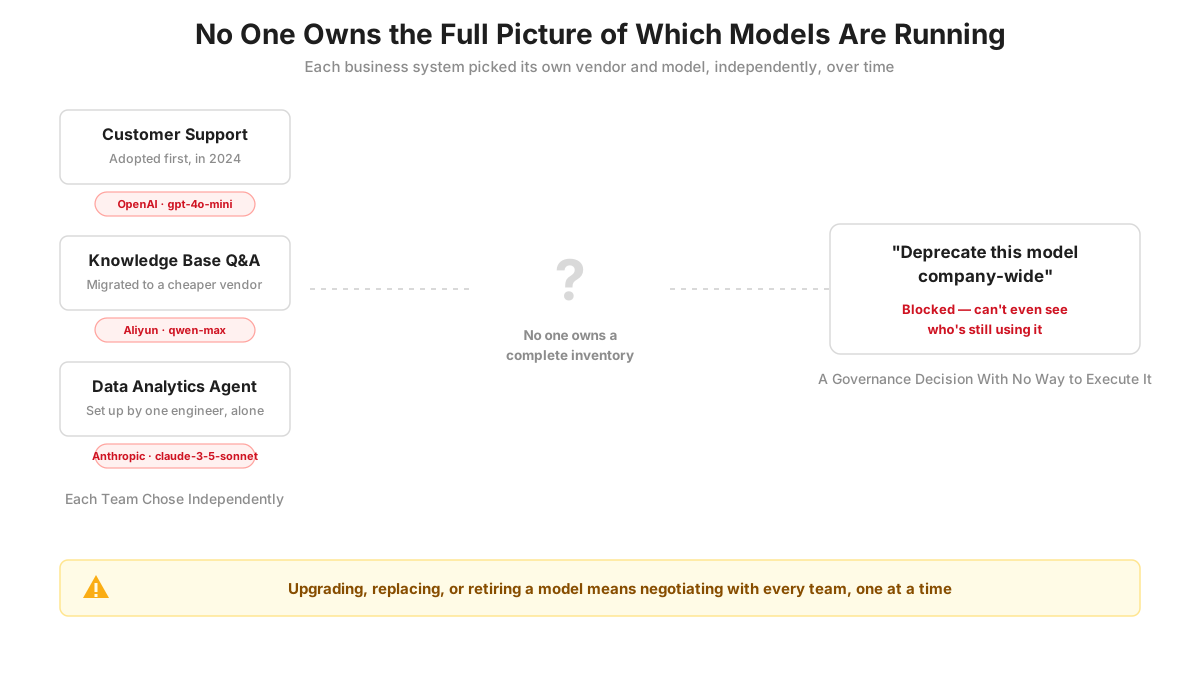
问下去才发现,这件事没人能一次说清楚。客服系统当年是用 OpenAI 接的,知识库问答后来改成了阿里云,数据分析 Agent 是另一个同事直接申请的 Anthropic Key,谁也不知道现在到底还有没有别的系统在悄悄调用别的模型。"统一升级"这四个字,还没开始执行,就先卡在了"根本不知道现状"这一步。
这不是个例。企业规模一大,模型这件事几乎必然走向碎片化——不是因为哪个团队技术不行,而是因为从一开始,"用哪个模型"就没有被当作一件需要企业统一决策的事,而是被交给了每个业务团队自己去选。
为什么模型治理这么难
1. 模型选型的决定权,一直分散在各个业务团队手里
没有统一规划,每个团队都是按自己当时接触到的资源、熟悉的供应商、能申请到的额度来选型——客服团队最早接入的是 OpenAI,知识库团队后来对接了阿里云,数据分析团队图方便直接用了 Anthropic。企业层面从没有人做过"我们应该用哪些模型、由谁来维护"这件事,选型权天然就是分散的。
2. 没有人手里有一份准确的"企业模型全景图"
问一句"我们现在有多少个业务系统在调用大模型、分别用的什么模型、什么版本、经过哪个供应商",往往没人能完整回答——各个团队只清楚自己那一块。想做统一升级,第一步"盘点现状"就做不到,更谈不上按计划推进。
3. 各团队的升级节奏永远不同步,新旧模型长期并存
即便某个团队升级了,别的团队可能还停留在更早的版本,甚至调用方式都不一样——有的走统一封装,有的直接拿供应商的 Key 连过去。模型版本、供应商、调用方式在企业内部长期处于碎片化状态,而且没有任何收敛的趋势:不是没人想统一,是根本没有一个能让"统一"落地的地方。
4. 治理决策没有一个可以一次性执行的入口
安全团队说"这家供应商的模型有合规风险,不能再用了";财务说"预算要集中到性价比最高的几个模型上"——这些本该是企业级的治理决策,但因为模型分散在各个业务系统自己的代码里,没有一个地方能一次性落地,只能一个团队一个团队去谈、去改。治理决策变成了旷日持久的拉锯,而不是一次配置变更就能生效的事。
问题的根源:模型从来没有被当作一份可以统一治理的企业资产
以上几个问题,本质上是同一件事——每个业务系统都在"各自为政"地选型、调用、维护自己的模型,没有一个地方能看到全貌、做出统一决策。模型的选型权、调用权散落在各个团队手里,升级、替换、下线任何一个模型,都变成了要挨个说服、协调一堆独立团队的漫长工程,而不是修改一份配置。
更合理的做法:模型调用统一收拢到一层,升级才有地方可以落地
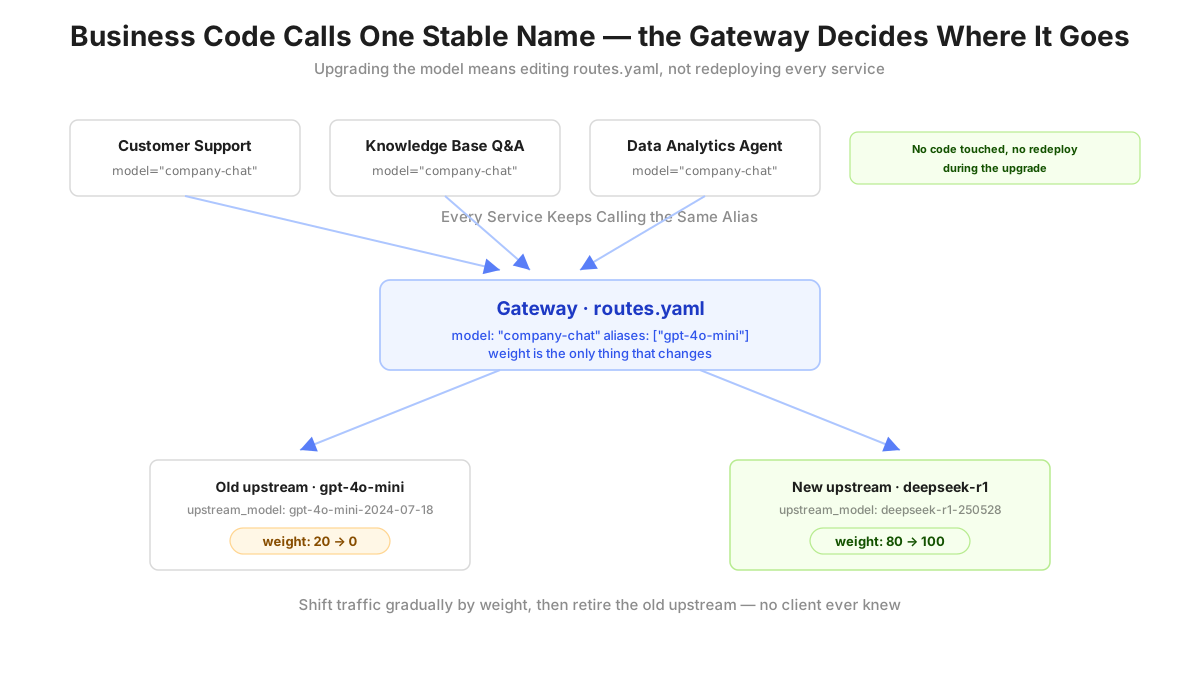
网关本来就处在所有模型调用的必经位置——业务系统的每一次请求,最终都要经过网关才能到达具体的模型后端。这意味着,"企业里到底有哪些模型在跑、分别指向谁",完全可以在网关这一层看得一清二楚,升级、替换、下线也可以在这一层统一执行,而不需要业务代码知道,也不需要挨个说服每个团队。
具体来说,这一层至少要提供三件事:
- 客户端看到的模型名,和实际路由到的后端解耦:业务方一直调用一个稳定的名字(比如
company-chat),网关配置里决定这个名字实际转发到哪个供应商、哪个模型,业务代码永远不用改; - 旧名字继续可用:即便新模型的官方名字变了,也可以把旧名字设成新配置的别名,历史请求不用等业务方逐一迁移,直接享受升级;
- 按比例灰度切换:不是"全量切"或者"完全不切",而是先给新模型分配一小部分流量权重,观察效果、成本、稳定性都没问题之后,再逐步把权重加到 100%,出问题随时把权重调回去——全程不需要业务系统重新发布。
企业能不能统一治理模型,不取决于开了多少次协调会,取决于有没有一个地方能一次看清"现在到底有哪些模型在跑"
ModelPointer 如何解决这个问题
ModelPointer 在设计上,客户端看到的模型名和实际路由到的后端从一开始就是两件事,企业里所有模型的选型、路由都收拢在同一份 routes.yaml 里,第一次有了可以查看的全景图:
- 一份配置,看清全部路由:一个企业调用的所有模型、供应商、版本,都在同一份
routes.yaml里声明,不需要再去问每个业务团队"你在用什么模型"; - 模型名与上游模型解耦:
routes.yaml里通过upstream_model把客户端传的模型名翻译成上游实际需要的名字,业务方调用的名字可以永远不变,即便上游模型的版本号已经换了好几轮; - 别名机制:一个模型可以配置多个
aliases,旧名字和新名字都能路由到同一份配置,模型升级时不需要业务方同步改调用参数; - 加权路由做灰度:同一个模型名下可以配置多个上游,通过权重(SWRR)控制流量比例,新旧模型可以按比例并存,逐步把权重从旧模型移到新模型;
- 热重载,零停机切换:无论是 YAML 文件还是数据库配置,调整路由权重都会在下一次同步周期内生效,不需要重启网关,更不需要业务系统配合发布;
- 协议独立:OpenAI 协议和 Anthropic 协议可以各自配置独立的路由和权重,用同一套模型升级也不会互相影响。
结语
新模型层出不穷,企业却迟迟用不上,表面看是"决策慢",实际上是"模型从来没有被当作一份需要统一治理的企业资产"——选型权散落在各个团队手里,企业连自己有多少模型在跑都说不清,升级自然无从谈起。
模型多久能用上,不取决于评测分数多亮眼,取决于企业有没有一个地方能一次看清、一次改动所有模型的调用
把模型的选型权、路由权收拢到网关这一层,模型升级会从一次需要挨个说服十几个团队的治理难题,变成一次配置文件的修改和一次权重调整。
官网:https://modelpointer.com · GitHub:https://github.com/modelpointer/modelpointer
关于这个系列
这是"AI Gateway 与企业 AI 基础设施"系列的第五篇。前四篇分别讲了这一层基础设施为什么会出现、为什么 API Key 不能直接下发给业务系统、私有化部署之后为什么仍然需要云端模型,以及大模型账单为什么总说不清花在了哪儿:
👉 为什么企业开始需要 AI Gateway? 👉 企业为什么不能把大模型 API Key 直接发给业务系统? 👉 为什么企业部署本地大模型后,仍然需要云端模型? 👉 企业每月的大模型账单,为什么总说不清花在了哪儿?
后面还会继续写这个系列,聊聊按任务复杂度做模型路由、私有化与云端的成本对比这些具体问题。想第一时间收到更新,欢迎关注公众号「AI自动化指南」:
